안녕하세요. 뉴스레터 구독자 여러분, 디지털 정보처 데이터 hub팀의 이진숙입니다.
이번 2월호에서는 AI선배를 구현할 때 많이 참고했던 UC 버클리의 Zachary A. Pardos 교수님 연구 중 하나를 고려대학교 데이터에 적용해보고자 합니다.
참고한 논문의 제목은 "A University Map of Course Knowledge"으로 제목을 클릭하시면 해당 링크로 이동하실 수 있습니다.
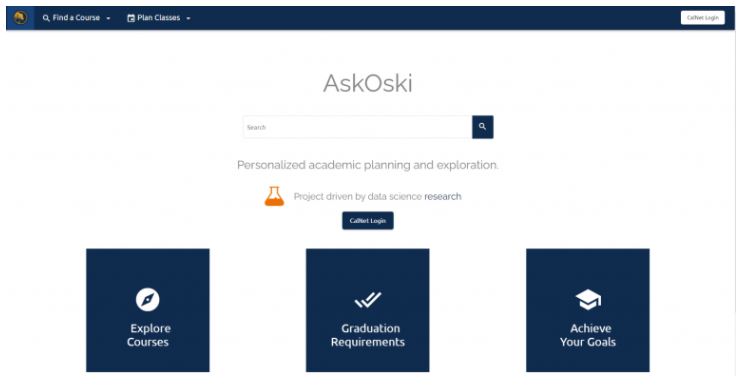
AskOski
고려대학교의 AI선배와 같이 UC 버클리에서는 AskOski라는 이름으로 강의 탐색 및 맞춤형 추천서비스를 제공하고 있습니다. AskOski에서는 강의 검색은 물론 맞춤형 강의 플랜까지 제공해주고 있는데요. 탐색한 강의 중 마음에 드는 강의가 있으면 저장 버튼을 누르고 시스템 상에서 그에 맞게 동적으로 졸업하기 전까지 어떤 강의를 수강하면 좋은지 학기별 추천을 제공해줍니다.
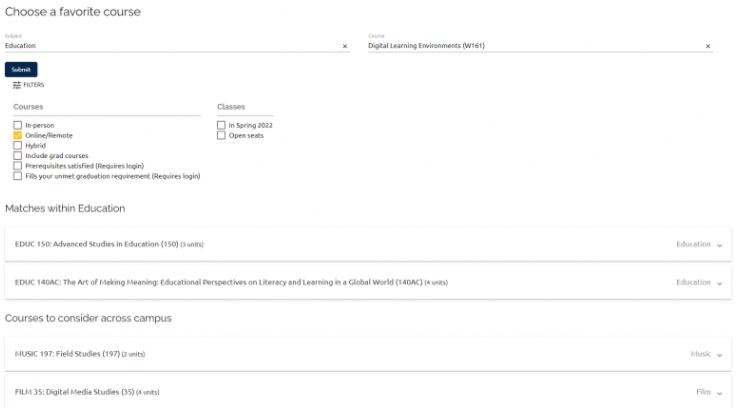
아래의 그림과 같이 강의 탐색에서는 자신이 수강했던 강의 중 가장 좋았던 강의를 선택하면 이와 비슷한 강의를 추천해주는 내용 기반의 추천이 이루어지는데요. 강의 방식, 대학원 강의 포함여부, 선수강요건 만족 여부, 졸업요건 만족 여부에 대한 필터 기능도 함께 제공합니다. 추천 리스트에는 같은 단과대(학과)에서 유사한 강의, 다른 단과대에서 개설한 유사한 강의를 나누어서 추천해줍니다.
이 서비스를 개발한 연구실에서는 다양한 머신러닝 알고리즘을 수강이력 데이터에 접목하고 있는데요. 오늘은 그 중 자연어처리 모델을 적용한 Course2Vec을 소개하고자 합니다.
- Word2Vec에서 Course2Vec
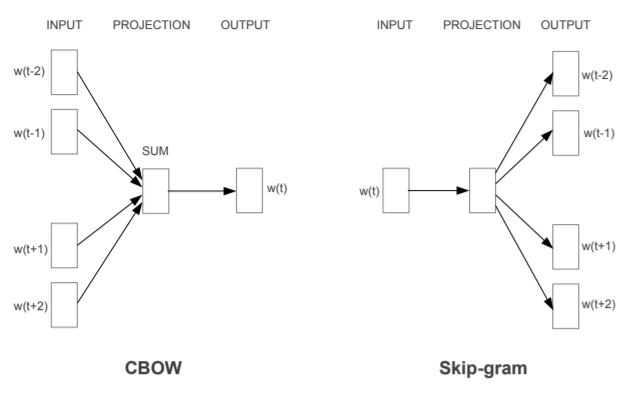
이 연구에서 제시한 Course2Vec은 문장 대신 수강 이력 다양한 히스토리를 넣어서 이를 학습시키는 방법으로 소개하였는데요. 아래의 그림을 통해 설명해보도록 하겠습니다. 해당 논문에서는 문장 대신에 학생의 수강이력을, 단어 대신에 강의로 치환하였습니다. 그래서 한 토큰은 강의가 되는 것이고 학기내 수강이력을 랜덤 셔플링을 진행합니다. 그리고 지정한 벡터 크기와 window크기에 맞춰서 훈련을 진행하는데요. 결국 사용자가 지정한 차원에 해당 강의들을 임베딩하게 됩니다. 모델은 여러 학생들의 수강이력 순서를 학습하면서 일종의 시퀀스를 학습하게 되고 추천을 해줄 땐 선택한 강의와 가장 유사한 강의 n개를 출력해주게 됩니다.
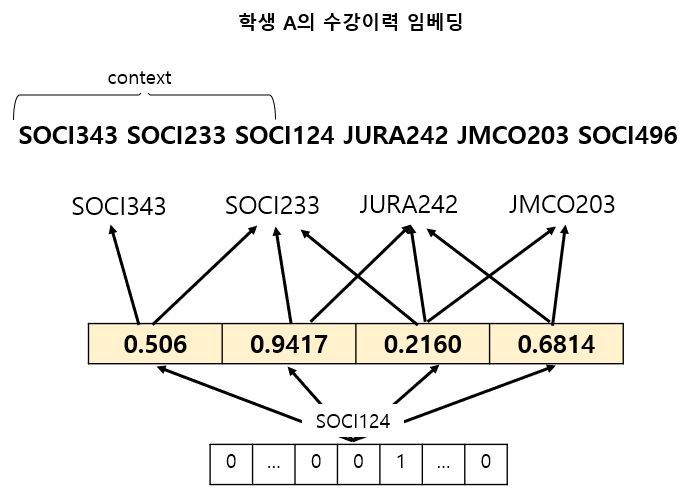
본 연구에서는 vector size, window, negative sampling, hierarchical softmax 등의 하이퍼파라미터 튜닝을 거쳐 400개의 모델을 실험하고 그 중 가장 validation수치가 높은 모델을 선정했는데요. validation은 사전에 지정된 유사 강의 목록 등을 참고하였다고 합니다.
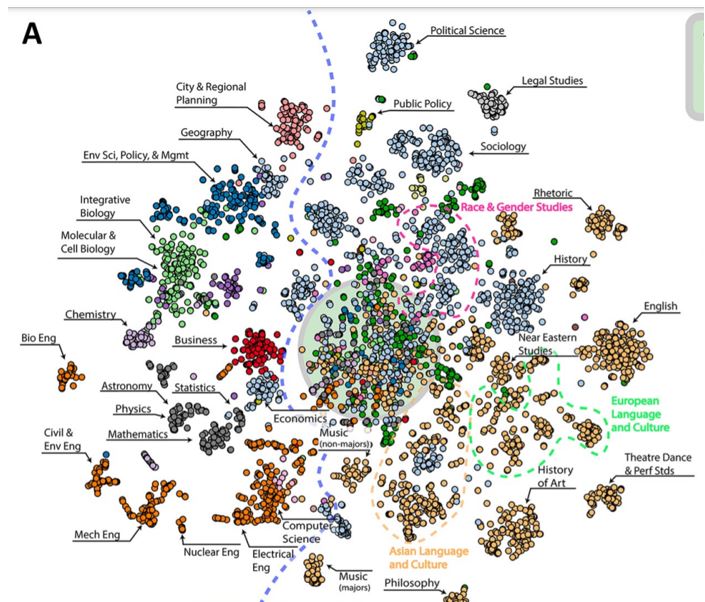
아래의 그림은 최적의 모델이 임베딩한 강의의 벡터를 차원 축소(TSNE)하여 표현한 것입니다. 색깔은 해당강의의 개설 단과대로 표시하였다고 합니다. 자세히 살펴보면 왼쪽과 오른쪽을 기점으로 이공계와 인문계 학과 강의가 나누어져 있고, 같은 학과의 강의들이 잘 클러스터링 되어있는 것을 보실 수 있습니다. 가운데에 다양한 강의가 뭉쳐진 부분은 하위 단과대로 상위 단과대가 같은 강의로 뭉쳐져있다고 하였습니다.
Course2Vec at Korea University
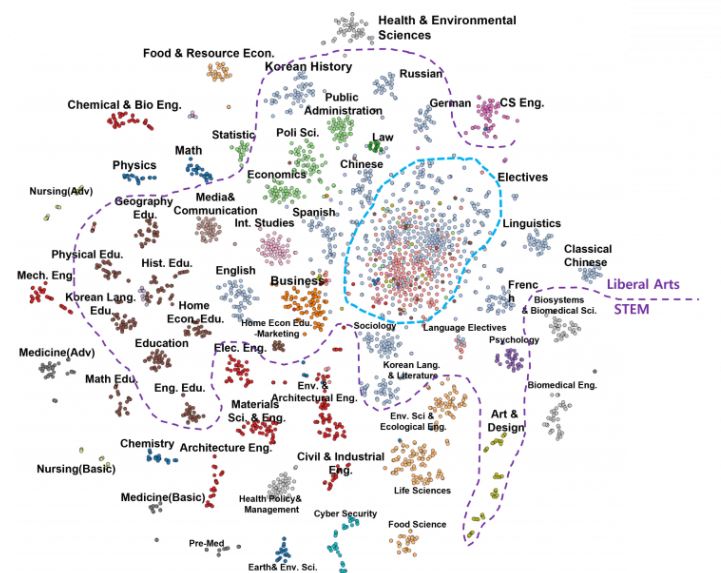
저는 이를 고려대학교의 수강이력 데이터에 그대로 적용시켜보았는데요. 2015년부터 2021년까지 28학기의 수강이력 884,808건을 활용한 결과입니다. 2학점 이상인 강의만 선택하였고 30회 이상 수강되지 않은 강의는 제거하였습니다. 이 때의 벡터 크기는 200, epoch은 100번으로 결과는 아래의 그림과 같습니다. 물론 사전에 지정된 유사 과목 리스트를 확보하지는 못하여 몇 번의 튜닝으로 얻어낸 랜덤한 결과입니다만, 꽤 클러스터링이 잘 되어있는 것을 확인할 수 있었습니다. 제가 만들어낸 차원축소 그림에서는 안과 밖으로 인문계와 이공계가 나뉘어져 있었고 안쪽 부분에 교양 강의들이 많이 포진한 것을 확인할 수 있었습니다.
논문의 저자는 조금 더 micro-level에서 해당 차원 축소 부분을 뜯어보고 다양한 기준에서 validation을 하고자 노력했는데요. 실제 과목 개요 텍스트 데이터도 활용해 함께 벡터화 시키는 부분에서 흥미로운 부분이 많았고 개인적으로도 조금 더 develop해보고 싶은 연구였습니다. 다음 호에는 더 흥미로운 주제로 찾아뵙겠습니다. 감사합니다.
Reference
Pardos, Z. A., & Nam, A. J. H. (2020). A university map of course knowledge. PloS one, 15(9), e0233207.