Data@KU 구독자 여러분 안녕하세요. 디지털정보처 데이터Hub팀 김진원입니다. 코로나 팬데믹으로 인해 2년동안 진행되지 못했던 대동제와 입실렌티가 드디어 진행되어 감회가 새롭습니다. 직접 가진 못했지만, 수많은 학생들로 북적이는 고려대학교 캠퍼스를 지켜보니 예전 학부생 시절에 걱정거리 하나 없이 민주광장과 녹지운동장에서 축제를 즐겼던 모습이 떠올라서 저 또한 기분이 너무 좋았습니다. 그동안 축제를 즐기지 못해 아쉬움만 삼켰던 고대인들의 기다림이 어느 정도는 해소된 것 같아 다행입니다.
오늘은 하나의 프로세스 내에서 둘 이상의 스레드가 동시에 작업을 수행하는 멀티 스레드(multi thread)에 대한 개념을 간단히 알아보고 예제를 통해서 어떻게 실행되는지 확인해보는 시간을 갖고자 합니다. 스레드는 하나의 프로세스 안에서 다양한 작업을 담당하는 최소 실행 단위라고 이해하시면 될 것 같습니다. 따라서 멀티 스레드는 CPU의 최대 활용 및 리소스 낭비 방지를 위해서 프로그램의 둘 이상을 동시에 실행하는 프로그래밍이며 동시성 처리를 위한 프로그래밍으로도 불립니다.
멀티 스레드 프로그래밍은 비동기 작업을 실행합니다. 이와 반대되는 개념인 동기 작업은 A작업이 시작되고 있으면 A작업이 끝나기 전까지는 B작업이 시작될 수 없습니다. 하지만 비동기 작업은 A작업을 시작하는 동시에 바로 B작업, C작업에도 제어권이 넘어가면서 작업이 시작되는 것을 의미합니다. 따라서 각각의 개별적인 작업이 서로에게 영향을 주지 않는 경우에 멀티 스레드 프로그래밍을 활용할 경우 압도적인 성능 향상이 있을 수 있습니다. 예를 들어 싱글 스레드 프로그래밍에서 A파일, B파일, C파일, D파일 ··· 등등의 수많은 파일을 순차적으로 생성하는 경우에는 A파일을 생성한 후에 B파일을 생성할 수 있고, 그 이후에 C파일, D파일을 생성하게 됩니다. 하지만 A파일을 생성하기 위한 작업 시간이 오래걸리게 된다고 가정하였을 때, 미리 B파일을 검증해보고 싶은 사용자에게는 효율적이지 못할 수 있습니다. 따라서 A파일, B파일, C파일 등등의 생성 작업이 독립적인 경우에는 멀티 스레드 프로그래밍을 활용하면 작업을 보다 효율적으로 완료할 수 있게 됩니다.
멀티 스레드 프로그래밍을 어떻게 실행할 수 있는지 예시를 통해 알아보겠습니다. 멀티 스레드의 경우 threading 모듈을 통해서도 구현이 가능하지만, 저는 Python 3.2 버전부터 지원하는 concurrent 모듈의 futures 패키지를 활용하고자 합니다. 기존 threading 모듈의 경우 코드 구현이 복잡하고, context switching에 대한 깊은 이해가 필요한 반면, futures는 비동기 실행을 비교적 쉽게 할 수 있고, 실행 중인 작업 취소, 완료 여부 체크, 타임아웃 옵션 추가 등 사용자가 편리하게 사용할 수 있다는 장점이 있습니다.
온라인 강의 및 학위 플랫폼 Coursera 강의들의 링크를 크롤링하는 코드를 직접 구현해보았고, 이를 단순 반복문을 활용했을 때와 멀티 스레드를 활용했을 때의 속도 차이가 어느 정도로 나는 지를 비교해보았습니다.
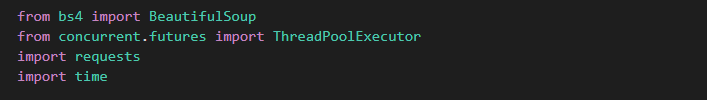
먼저 크롤링할 때 필요한 모듈과 멀티 스레드를 할 때 필요한 모듈을 그림 1과 같이 import 해옵니다.
<그림 1>
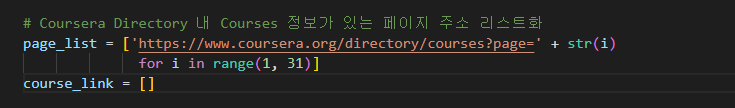
그리고 난 후 그림 2와 같이 예시 차원에서 coursera directory 내 courses 정보가 있는 페이지 주소를 1페이지부터 30페이지 주소까지 리스트화 시킵니다. 그리고 페이지에 존재하는 모든 Coursera 강의들의 링크 주소를 크롤링하여 저장할 course_link 리스트를 생성합니다.
<그림 2>
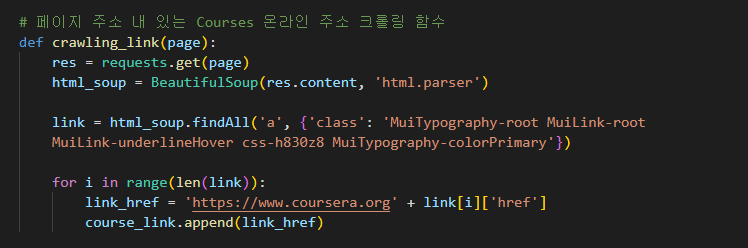
다음 그림 3은 크롤링할 때 보편적으로 사용하는 BeautifulSoup을 활용하여 html을 파싱하고 링크 주소에 해당하는 정보들을 크롤링해오는 함수에 해당합니다.
<그림 3>
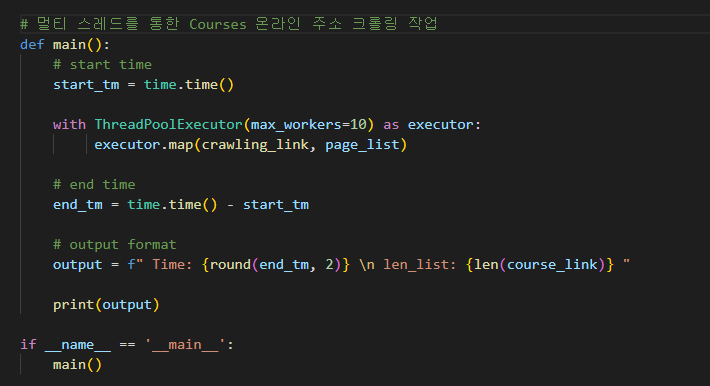
마지막으로는 멀티 스레드를 하기 위한 코드를 main 함수에 작성하는 것이 필요한데요, 굉장히 코드는 간단합니다. ThreadPoolExecutor 함수를 활용하고, 그림 4에서 보시는 것과 같이 map 함수를 활용하여 위에서 사전에 작성한 crawling_link 함수와 함수에 적용시킬 page_list 리스트를 파라미터로 넣으면 됩니다. 한번 실행을 해보겠습니다.
<그림 4>
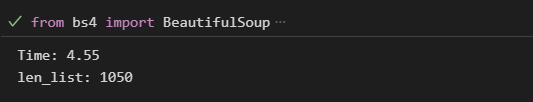
작업 속도는 약 4.55초, 수집된 강의 링크 개수는 1050개가 됩니다.
<그림 5>
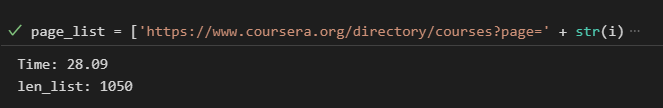
만약에 이를 통상적으로 활용하는 For 반복문을 통해 실행하게 되면 어떻게 될까요? 약 28.09초로 더 많은 시간이 소요되는 것을 확인할 수 있습니다. 물론 수집된 강의 링크 개수는 1050개로 동일합니다.
<그림 6>
지금까지 실제 예제를 통해 멀티 스레드를 활용하는 방법에 대해 다뤄봤습니다. 이번에 구현한 크롤링 작업은 페이지마다 서로 영향을 주지 않기 때문에 동시성 처리를 했을 때 효율성이 극대화될 수 있는 작업이라고 볼 수 있습니다. 물론 이번 예제에서는 간단한 함수만을 활용하였지만 크롤링과 같은 작업은 세세하게 작업의 흐름을 제어해야 하는 경우가 많기 때문에 "wait"이나 "as_completed"라는 함수 활용이 권장된다고 합니다. 궁금하신 분들은 여기를 통해 확인해보시면 좋을 것 같습니다.
물론, 멀티 스레드 자체가 굉장히 복잡한 개념입니다. 상황에 따라 멀티 프로세싱이 더 효율적일 수도 있고, 어떤 경우에는 동시성 처리가 오히려 작업에 좋지 않은 영향을 줄 수도 있습니다. 저도 아직 동시성 처리를 위한 코드 구현에 대해 계속 공부를 하고 있는데요, 동시성 처리에 관심이 있는 여러분들도 나중에는 자유롭게 코드를 구현할 수 있는 날이 오기를 바랍니다. 긴 글 읽어주셔서 감사드리며, 무더운 날씨에 지치시지 마시고 힘내세요!