Data@KU 구독자 여러분 안녕하세요! 디지털정보처 데이터Hub팀 김진원입니다. 즐거운 여름방학 보내고 계신가요? 지난주에는 기온이 36도에 육박해서 숨쉬기 조차 힘든 한 주였던 것 같습니다. 😢😢 또 변이 코로나 바이러스가 기승을 부려서 아직은(?) 코로나에 걸리지 않은 저도 걱정이 많이 되는 시기인 것 같습니다. 모든 고려대학교 구성원 여러분들이 건강하게 어려운 시기를 잘 버티시면 좋을 것 같습니다 😊
오늘은 지난번 Multi-Thread 프로그래밍을 통한 수집한 Coursera 강의 내용과 콘텐츠 기반 추천 알고리즘을 활용하여 대학원생들에게 Coursera 강의를 추천하는 과정을 실습해보고자 합니다. 지난 뉴스레터가 궁금하신 분들은 멀티 스레드(Multi Thread) 프로그래밍 맛보기와 해외 논문들을 활용한 자연어 처리 실습을 확인해주시면 감사하겠습니다.
지난 멀티 스레드를 활용한 Coursera 강의 수집은 강의들의 링크 주소를 수집하는데 그쳤습니다. 이후에 수집된 강의 링크 주소를 통해서 Coursera 강의들의 제목 / 강의 요약 / 강의를 통해 개발할 수 있는 기술의 세 가지 핵심 정보를 수집하였습니다. 수집된 정보는 다음과 같습니다.
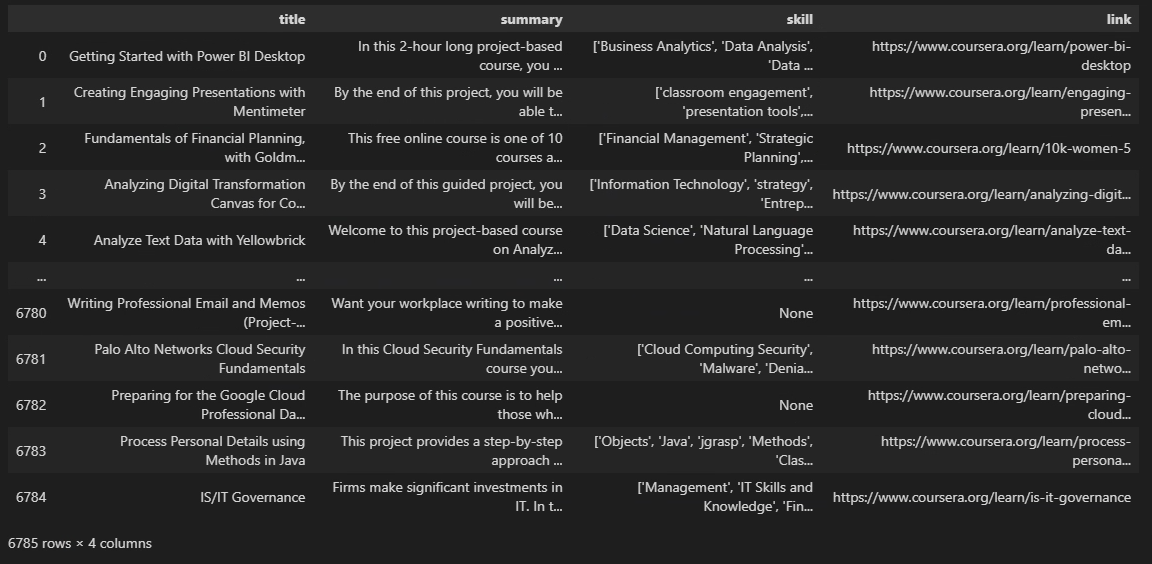
수집된 강의는 9618개이지만 스페인어, 아랍어 등으로 구성된 강의들도 존재해서 자막이 최소한 영어로 제공되는 강의만을 선별하여서 총 6785개의 Coursera 강의를 이번 분석에서 활용하고자 합니다.
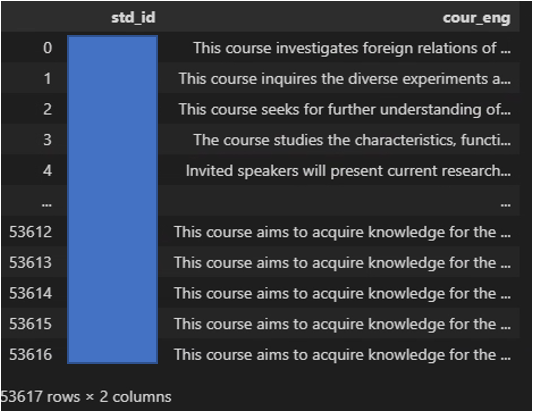
Coursera 강의를 추천하기 위해서는 대학원생들이 어떤 과목을 들었고, 해당 과목은 어떤 내용을 다루고 있는지를 파악하는 것이 선행되어야 합니다. 대학원생들이 수업을 들은 과목의 담당 교수님들이 강의 계획서를 업로드하시기는 하지만 어떤 분들은 PDF로 올리기도 하시고, 어떤 분들은 Word 파일 / 한글 파일의 형식으로 업로드를 하시기도 하시며 혹은 홈페이지에 기입하시는 분들도 존재합니다. 형식이 통일되지 않은 문제가 있기 때문에 교수 요목 정보를 활용하고자 합니다. 교수 요목은 해당 과목이 어떤 내용을 다루는지에 대한 간략한 소개 글입니다. 학생들의 수강이력을 통해 수집된 교수 요목 정보들은 다음과 같습니다 (학생들이 여러 강의를 수강하기 때문에 자료는 Long data format을 취하고 있습니다).
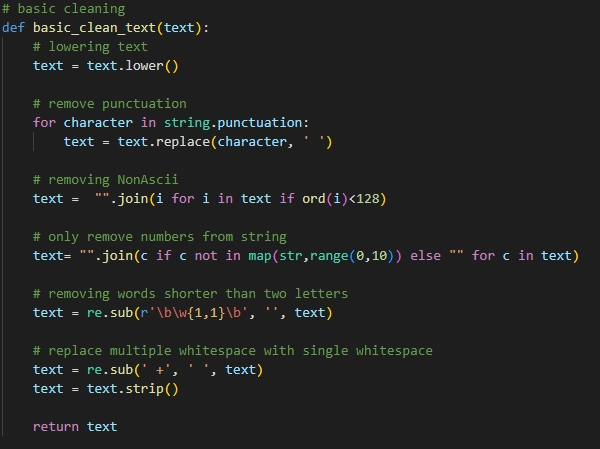
이렇게 수집된 텍스트들을 지난번과 유사한 방식으로 전처리하고 토큰화하는 것을 진행하였습니다. 아직 전처리에 익숙하지 않으신 분들을 위해서 제가 제작해놓은 코드를 공유해드립니다 (제 코드는 정답이 아니므로 보다 더 효율적이고 정확한 코드가 있을 수 있음을 고려해주시기 바랍니다^^).
먼저, 간단한 Text Cleaning을 아래의 코드를 통해 진행하였습니다. 문장부호(punctuation)제거, 숫자 제거, 2글자 미만의 단어 제거 등을 진행하는 코드라고 이해하시면 될 것 같습니다.
그리고 그 다음 단계로는 1차적으로 전처리된 텍스트들로부터 표제어(lemmatization)를 추출하고 이를 토큰화하여 불용어(stopword)를 처리하는 단계를 거쳤습니다. 저는 이번에 보다 더 의미있는 단어들만을 활용하기 위해서 품사 태깅을 통해서 명사와 형용사 품사를 갖고 있는 단어들을 추출하였습니다.
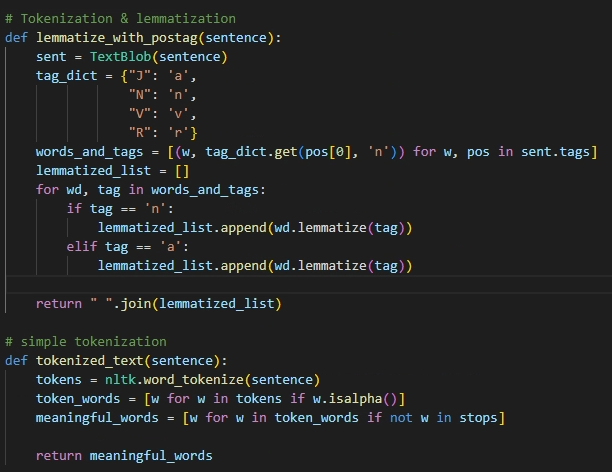
그 다음 단계로는 전처리된 텍스트 속에서 키워드들을 뽑는 과정을 거쳤습니다. 이번 분석에서는 키워드 추출을 기존에 활용하였던 TF-IDF가 아닌 KeyBERT 알고리즘을 통해 진행하였습니다. TF-IDF는 텍스트의 통계적인 특성에 기반하고 있어 전체 문서의 의미적인 측면을 고려하지 않는다는 한계점을 갖고 있습니다. 반면, KeyBERT는 TF-IDF의 한계점을 해결하기 위해 사용하기 쉬운 키워드 추출 방법에 해당합니다. KeyBERT는 BERT 언어 모델을 활용하는데 본 분석에서는 'all-MiniLM-L6-v2' BERT 모델을 활용하여 키워드를 추출하였습니다. KeyBERT에 대한 자세한 설명은 이를 개발한 Maarten Grootendorst의 Github 자료를 참고해주시기 바랍니다. 키워드는 기본적으로 5개씩을 추출하였는데, Coursera 강의의 경우 강의 제목과 강의를 통해 개발이 기대되는 기술의 텍스트는 모두 활용하였고, 긴 문장으로 구성되어 있는 강의 요약에서 키워드를 5개를 추출하였습니다. 학생들의 수강과목 키워드 또한 학생들이 수강한 과목 각각에서 키워드를 5개씩 추출하고 이를 합쳐 구성하였습니다.
이렇게 추출된 Coursera 강의와 학생의 수강과목 키워드는 다음과 같습니다.
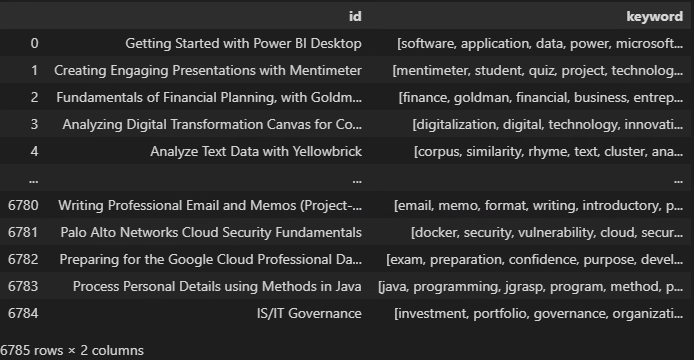
<Coursera 강의 키워드>
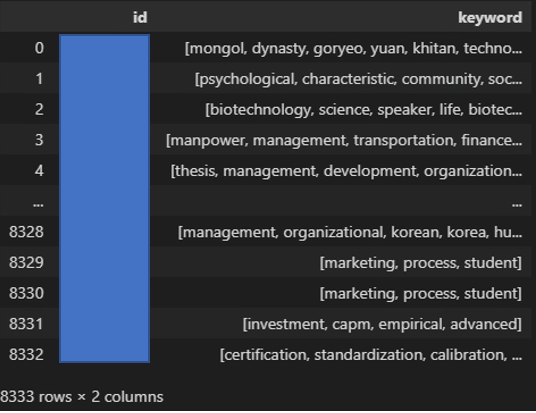
<학생 수강과목 키워드>
이제 키워드 추출까지 모두 완성되었습니다. 마지막 단계로 추출된 키워드를 토대로 문서 간 유사도를 계산하고 유사도가 높은 5개의 Coursera 강의를 학생들에게 추천하는 과정을 거쳤습니다. 문서 간 유사도는 지난 분석과 동일하게 코사인 유사도를 활용하였습니다. 한번 결과들을 살펴볼까요?
결과 예시로 교육학과에 재학 중인 A학생, 뇌공학과에 재학 중인 B학생, 기계공학과에 재학 중인 C학생의 결과를 가져왔습니다 (결과가 작게 보이는 관계로 확대 부탁드립니다).
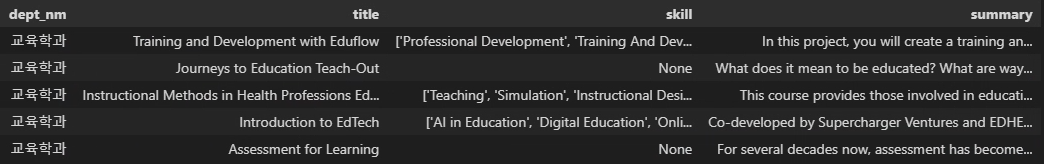
<교육학과 A학생에게 추천된 Coursera 강의 목록>
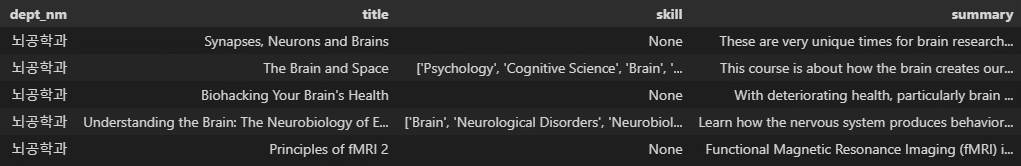
<뇌공학과 B학생에게 추천된 Coursera 강의 목록>
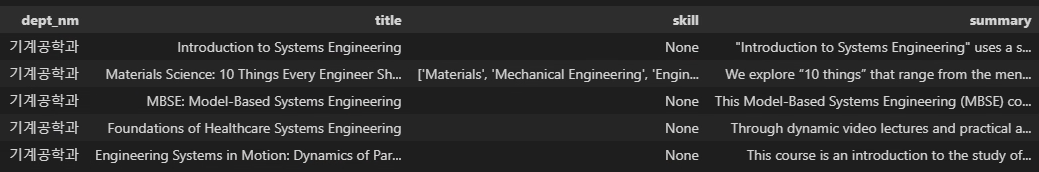
<기계공학과 C학생에게 추천된 Coursera 강의 목록>
참고로, Skill(강의를 통해 개발이 기대되는 기술)에 None으로 결측값 처리가 된 것은 해당 강의에 Skill 관련 정보가 누락되어 있기 때문입니다. 추천 결과에 대한 성능은 검토가 필요하지만, 학과 특성이 잘 반영된 추천 결과라고 볼 수 있을 것 같습니다. 단순히 키워드만을 추출하고 이를 활용하여 강의들을 추천할 수 있다는 점은 흥미로운 것 같습니다. 지금까지 뉴스레터를 읽어주셔서 감사합니다 😉 다음에는 다른 추천 알고리즘을 통하여 대학원생들에게 유익한 강의를 추천하는 과정을 보여드리고자 합니다. 다음 뉴스레터 때 뵙겠습니다! 이와 별개로 뉴스레터에서 다루면 좋을 것 같은 내용들도 언제든지 이메일(herojin333@korea.ac.kr)로 말씀해주시면 반영해보도록 하겠습니다. 감사합니다.